Logging, Tracing & Audit Trail: একটি Software System এ শুধু Log কি যথেষ্ট?
বর্তমানে একটি Software Product তৈরি করা আগের চেয়ে অনেক সহজ হয়ে গেছে। AI assisted development এর কারণে অনেকেই এক দুই দিনের মধ্যে একটি কার্যকর MVP তৈরি করে লঞ্চ করে ফেলেন। কিন্তু Product লঞ্চ করার পর আসল চ্যালেঞ্জ শুরু হয় Security, Observability এবং Auditability এর বিষয়গুলো সামনে আসলে।
একটু ভেবে দেখুন, আপনার সিস্টেমের কোনো একজন User এর গত ৩০ দিনের সমস্ত Activity এর Report যদি হঠাৎ চাওয়া হয়, আপনার সিস্টেম কি নির্ভুলভাবে সেই Report দিতে পারবে?
অথবা ধরুন, একজন Customer এসে সরাসরি দাবি করল আমার Account থেকে টাকা কেটে নেওয়া হয়েছে, কিন্তু আমি কোনো Transaction করিনি! তখন কি আপনি proper data trail দিয়ে সাথে সাথেই বিষয়টা প্রমাণ করতে পারবেন?
ট্রানজেকশনটি ঠিক কোন Actor ইনিশিয়েট করেছিল, রিকোয়েস্টটি কোন রিয়েল ক্লায়েন্ট IP ও ডিভাইস থেকে এসেছিল, ইন্টারনাল কোন কোন সার্ভিস বা থার্ড-পার্টি গেটওয়ে পার হয়ে ফান্ড ডিসবার্স হলো এবং ডাটাবেসের সেই রেকর্ড যে পরবর্তীতে কেউ ট্যাম্পার বা পরিবর্তন করেনি তার নির্ভরযোগ্য প্রমাণ দেখানো, যেকোনো প্রোডাকশন সিস্টেমের জন্য একটি অপরিহার্য শর্ত।
বিশেষ করে Banking, Fintech এবং যেকোনো সেনসিটিভ সিস্টেমে যদি এই প্রশ্নগুলোর নির্ভুল উত্তর তাৎক্ষণিকভাবে দেওয়া সম্ভব না হয়, তবে এটি কেবল একটি সাধারণ সফটওয়্যার বাগ নয়, বরং সরাসরি আইনি দায়বদ্ধতা, ফাইনান্সিয়াল পেনাল্টি এবং ব্র্যান্ড ভ্যালু ধ্বংস হওয়ার মতো বিপর্যয় ডেকে আনতে পারে।
শুধু সাধারণ Application Logs দিয়ে সবসময় এসব প্রশ্নের উত্তর পাওয়া সম্ভব নয়। এর জন্য প্রয়োজন একটি সঠিক Logging, Tracing এবং Audit Trail Architecture।
অনেক সময় আমরা অনেকে Application Logging এবং Audit Logging কে একইভাবে বিবেচনা করি। কিন্তু বাস্তবে এদের উদ্দেশ্য সম্পূর্ণ আলাদা।
Application Logging মূলত সিস্টেমের ভেতরে কোথায় কী ঘটছে তার ট্র্যাক রাখা এবং কোনো সমস্যা হলে তার রুট কজ খুঁজে বের করার জন্য ব্যবহার করা হয়। যেমন কোন HTTP Request কোন এন্ডপয়েন্টে hit করলো, ব্যাকএন্ডে কোন Service বা Repository Method কত সময়ে Execute হলো, কোনো Third-party API Call সফল হলো কি না, ইনপুট আউটপুট ডাটা কিংবা কোথায় অপ্রত্যাশিত Exception ও Stack Trace তৈরি হয়েছে।
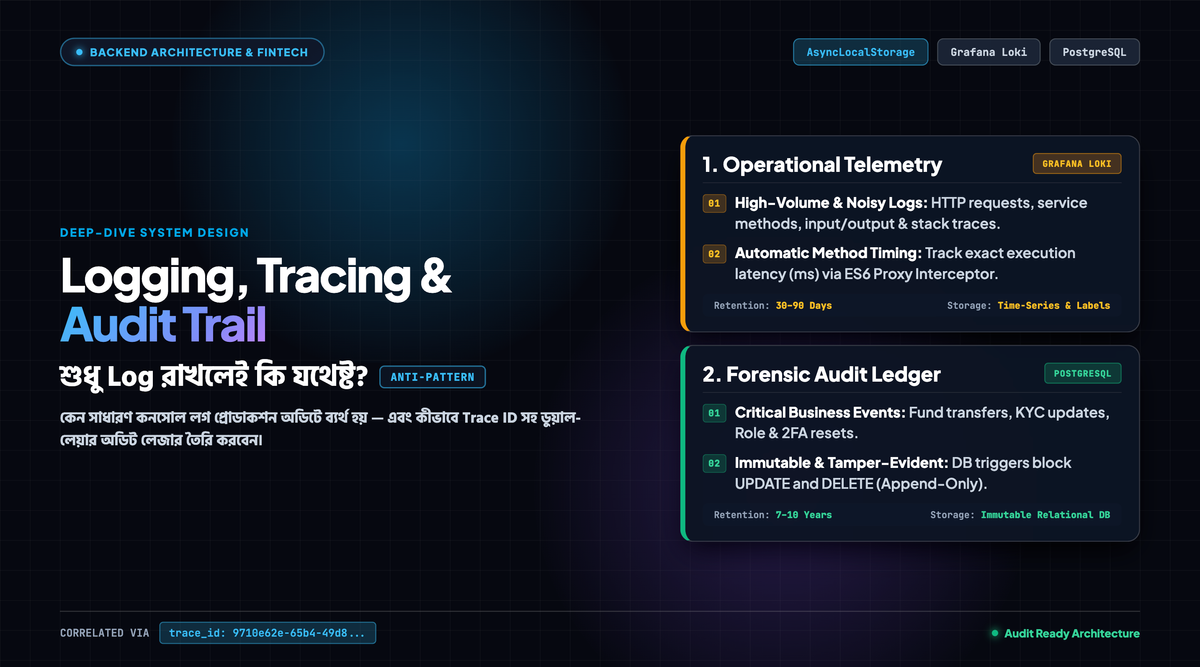
অন্যদিকে, Audit Logging এর মূল উদ্দেশ্য হলো সিস্টেমে ঘটা যেকোনো গুরুত্বপূর্ণ Business Activity এবং State Change এর একটি নির্ভরযোগ্য, Immutable Historical রেকর্ড সংরক্ষণ করা।
যেমন ফাইন্যান্সিয়াল ট্রানজেকশনে কে ফান্ড ট্রান্সফার ইনিশিয়েট করল (Maker) আর কে সেটি Approve বা Reject করল (Checker); কোনো User Account বা প্রোফাইলে কী তথ্য পরিবর্তন করা হলো এবং পরিবর্তনের আগের ও পরের ভ্যালু কী ছিল, কোনো সাপোর্ট এজেন্ট বা অ্যাডমিন কার সেনসিটিভ ডেটা (যেমন ব্যাংক ব্যালেন্স, এনআইডি নম্বর বা ট্রানজেকশন হিস্ট্রি) ভিউ কিংবা excel/csv আকারে এক্সপোর্ট করল, কিংবা সিস্টেমের ভেতরে কার অ্যাক্সেস পারমিশন বা সিকিউরিটি রোল পরিবর্তন করা হলো, পাসওয়ার্ড বা 2FA রিসেট হলো এবং ঠিক কোন সেশন ও ক্লায়েন্ট IP থেকে এই পরিবর্তনগুলো সম্পাদিত হয়েছিল।
সহজভাবে বললে, Application Logs আমাদের Debugging এ সাহায্য করে, আর Audit Trail আমাদের Accountability এবং Compliance নিশ্চিত করতে সাহায্য করে।
Implementation.
অনেকেই সাধারণ ভুল করে প্রতিটি HTTP Request, Response, Service Call, Error এবং Stack Trace PostgreSQL এ সংরক্ষণ করি। শুরুতে হয়তো তেমন কোনো সমস্যা হবে না। কিন্তু Application এর Traffic বাড়ার সঙ্গে সঙ্গে Log এর পরিমাণও বাড়তে থাকবে। একসময় Database এর Storage, Indexing এবং Query Performance এর ওপর অপ্রয়োজনীয় চাপ তৈরি হবে
তাই সবচেয়ে বেস্ট অ্যাপ্রোচ হলো সিস্টেম ডিজাইনে এই দুটি বিষয়কে পুরোপুরি আলাদা রাখা। মানে আমরা Hybrid Storage Architecture ব্যবহার করতে পারি।
Grafana Loki — Operational Logging
Loki তে আমরা Operational Logs সংরক্ষণ করতে পারি। যেমন, HTTP Request/Response এর প্রয়োজনীয় Sanitized Data, Internal Service Execution Logs, Third-party API Call এর Metadata, Error Messages, Stack Traces এবং Execution Timing।
Loki Log এর Label বা Metadata Index করে এবং Log Data Chunk আকারে Object Storage এ সংরক্ষণ করতে পারে। ফলে বিপুল পরিমাণ Operational Log সংরক্ষণ করা সম্ভব।
PostgreSQL — Structured Audit Ledger
অন্যদিকে PostgreSQL এ রাখব গুরুত্বপূর্ণ Business Events এবং Audit Records। যেমন, User Authentication Activity, Financial Transaction Lifecycle, Maker-Checker Approval History, Account Modification এবং Business-critical Before/After Values। এখানে প্রতিটি Record এর সঙ্গে Actor Identity, Timestamp, Action এবং সংশ্লিষ্ট Resource এর তথ্য থাকবে।
এভাবে High-volume Operational Logs এবং Structured Audit Records আলাদা রাখা সম্ভব। ফলে Database অপ্রয়োজনীয় Log Data দিয়ে ভারী হবে না, আবার প্রয়োজনীয় Audit History ও সহজে Query করা যাবে।
এবার আসি আরেকটি গুরুত্বপূর্ণ টপিকে Trace ID. মডার্ন ব্যাকএন্ডে একটি API Request প্রসেস করতে গিয়ে অনেকগুলো Internal Service ও Third-party API এর উপর নির্ভর করতে হয়। যদি মাঝপথের কোনো একটি সার্ভিসে Error থ্রো করে, তখন Root-cause বের করা বেশ কঠিন। ঠিক কোন Request থেকে সমস্যাটি শুরু হলো, কোথায় ফেইল করল এবং প্রতিটি লেয়ারে ইনপুট-আউটপুট ডেটা কী ছিল তা ট্র্যাক করা Trace ID ছাড়া প্রায় অসম্ভব।
একই Trace ID যদি সংশ্লিষ্ট সবগুলো সার্ভিসের ভেতর দিয়ে প্রোপাগেট করা হয়, তাহলে পরবর্তীতে শুধু সেই ID টি দিয়েই পুরো Request এর Complete Journey ট্র্যাক করা সম্ভব।
একটা রিয়েল লাইফ সিনারিও চিন্তা করুন। ধরুন, একটি Fund Transfer Request সিস্টেমে আসলো। এরপর সেটি Authentication Middleware পার হয়ে Transfer Controller, Transfer Service, Account Repository এবং সবশেষে CBS Integration API ক্রস করে ডাটাবেসে ট্রানজেকশন সেভ করল।
এখন এই লম্বা জার্নিতে প্রতিটি সার্ভিস যদি নিজেদের মতো করে আলাদা আলাদা Request ID তৈরি করে, তাহলে পরবর্তীতে পুরো Execution Flow টি একসাথে মেলানো বা খুঁজে পাওয়া আক্ষরিক অর্থেই অসম্ভব হয়ে যাবে। এর সবচেয়ে ভালো সমাধান হলো রিকোয়েস্ট সিস্টেমে ঢোকার শুরুতেই একটি Unique Trace ID তৈরি করা এবং পুরো Execution Flow জুড়ে সেই একই ID ব্যবহার করা।
Node.js এ উদাহরণ:
import { randomUUID } from "node:crypto";

function traceContextMiddleware(req, res, next) {
    const traceId = randomUUID();
    req.traceId = traceId;
    res.setHeader("X-Trace-ID", traceId);
    next();
}
এখানে একটি গুরুত্বপূর্ণ Security বিষয় রয়েছে। Client থেকে পাঠানো Trace ID কে সরাসরি বিশ্বাস করা উচিত নয়। Backend নিজেই Internal Trace ID তৈরি করবে। Distributed Services এর মধ্যে Correlation প্রয়োজন হলে Validated W3C Trace Context (traceparent) ব্যবহার করা যেতে পারে।
এই Trace ID ব্যবহার করে Grafana Loki এবং PostgreSQL দুই জায়গা থেকেই একই Request এর সঙ্গে সম্পর্কিত তথ্য খুঁজে পাওয়া সম্ভব হবে। মনে রাখতে হবে, Trace ID শুধু Correlation এর জন্য; এটি Authentication বা Authorization এর জন্য নয়।
এখন প্রশ্ন হলো, পুরো রিকোয়েস্ট ফ্লো ট্র্যাক করার জন্য প্রতিটি Service এর ভেতর কি আমাদের ম্যানুয়ালি logger.info() বা logger.error() বসাতে হবে?আমাদের দৈনন্দিন অনেক অ্যাপ্লিকেশনেই দেখা যায়, Service Method এর ভেতরে বিজনেস লজিকের চেয়ে এই Logging Code ই বেশি জায়গা দখল করে থাকে
async function transferFund(payload) {
    logger.info("Transfer initiated", { trace_id:..., accountId: payload.fromAccountId });

    logger.info("Validating transfer payload", {trace_id:...,});
    await validatePayload(payload);
    logger.info("Payload validation passed", {trace_id:...,});

    logger.info("Fetching source account details", {accountNoId: ...});
    const account = await accountRepository.findById(payload.fromAccountId);
    logger.info("Account fetched successfully", {trace_id:...,});

    logger.info("Checking available balance", { requestedAmount: payload.amount, trace_id:... });
    await checkBalance(account, payload.amount);
    logger.info("Balance check passed", {trace_id:...,});

    logger.info("Calling Core Banking Service (CBS)", {trace_id:...,});
    const result = await cbsService.transfer(payload);
    logger.info("CBS transfer response received", { trxId: result.trxId, trace_id:...});

    return result;
}
ছোটখাটো অ্যাপ্লিকেশনে হয়তো এই ম্যানুয়াল পদ্ধতি কাজ করবে। কিন্তু প্রজেক্ট যখন বড় হতে থাকে, তখন এই একই লগিং কোড (Boilerplate) পুরো প্রজেক্টজুড়ে ছড়িয়ে পড়ে। ফলে ডেভেলপারদের মধ্যে লগিংয়ের ফরম্যাটে Inconsistency তৈরি হয় এবং ম্যানুয়ালি করতে গিয়ে অনেক সময় গুরুত্বপূর্ণ অপারেশন লগ করতে ভুল হওয়ার বা মিস হওয়ার ঝুঁকি থাকে.
এর সবচেয়ে ক্লিন সমাধান হলো লগিংকে Business Logic থেকে পুরোপুরি আলাদা করে একটি Centralized Interceptor বা Instrumentation Layer তৈরি করা। শুরুতেই খুব কমপ্লেক্স কিছু না ভেবে, আমরা চাইলে সিম্পল একটি Wrapper Function বানিয়ে নিতে পারি.
async function executeWithTracing(
   operationName,
   operation,
   context
) {
   const startTime = performance.now();

   try {
       const result = await operation();

       publishOperationalLog({
           traceId: context.traceId,
           operation: operationName,
           durationMs: performance.now() - startTime,
           status: "SUCCESS"
       });

       return result;

   } catch (error) {
       publishOperationalLog({
           traceId: context.traceId,
           operation: operationName,
           durationMs: performance.now() - startTime,
           status: "FAILED",
           error: sanitizeError(error)
       });

       throw error;
   }
}
এখন পূর্বের ম্যানুয়াল লগিংয়ের পরিবর্তে সেন্ট্রালাইজড executeWithTracing wrapper টি ব্যবহার করে সার্ভিস মেথডটি কল করতে পারি:
async function transferFund(payload, traceId) {

   await executeWithTracing("VALIDATE_PAYLOAD", () =>
       validatePayload(payload),
       {traceId, payload}
   );

   const account = await executeWithTracing("FETCH_ACCOUNT", () =>
       accountRepository.findById(payload.fromAccountId),
       {traceId, fromAccountId: payload.fromAccountId }
   );

   await executeWithTracing("CHECK_BALANCE", () =>
       checkBalance(account, payload.amount),
       {traceId, account: payload.amount }
   );

   const result = await executeWithTracing("CBS_TRANSFER", () =>
       cbsService.transfer(payload),
       {traceId}
   );s

   return result;
}
এখন প্রতিটি মেথড বা অপারেশনের ভেতর বারবার ম্যানুয়ালি এমন wrapper কল করাটাও অনেকের কাছে বেশ ক্লান্তিকর লাগতে পারে। তাছাড়া হিউম্যান এরর তো আছেই ভুল করে কোনো একটা মেথডে wrapper দিতে ভুলে গেলেই সেই step এর ট্রেসিং মিস হয়ে যাওয়ার বড় ঝুঁকি থাকে। তাহলে প্রশ্ন হলো, এর চেয়েও কি আরও স্মার্ট এবং ক্লিন কোনো অ্যাপ্রোচ আমরা ব্যবহার করতে পারি?
হ্যাঁ, এখানেই আসে Proxy Pattern.
তার আগে একটু বলি node:async_hooks মডিউলের AsyncLocalStorage ব্যবহার করে আমরা Trace ID কে একটি রিকোয়েস্ট/রেসপন্স সাইকেলের পুরো লাইফটাইম জুড়ে গ্লোবালি অ্যাক্সেস করতে পারি, কোনো প্যারামিটার পাসিং ছাড়াই, ডিটেইল দেখতে পারেন <https://nodejs.org/api/async_hooks.html>
ES6 Proxy / Interceptor: কোড পলিউট না করে অটোমেটিক লগিং
Node.js এ আমরা Proxy ব্যবহার করে পুরো সার্ভিস instance কে একটি সিঙ্গেল লেয়ার দিয়ে wrap করে ফেলতে পারি। এতে সার্ভিসের ভেতর যতগুলো মেথডই থাকুক না কেন, মেথড কল হওয়ার সাথে সাথেই proxy ব্যাকগ্রাউন্ডে তা intercept করবে।
তবে প্রোডাকশনে এটি করার সময় একটি বড় বিপদের ঝুঁকি থাকে Uncontrolled Output Logging। কোনো একটি মেথড যদি ভুলবশত ১০ হাজার ইউজারের অবজেক্ট কিংবা বিশাল ফাইল বাফার রিটার্ন করে, আর সেটা স্যানিটাইজ না করে সরাসরি লগে পাঠাতে যায় সার্ভারের মেমোরি আউট অব মেমোরি হয়ে পুরো নোড প্রসেস নিমেষেই ক্র্যাশ করবে! তাই প্রক্সির সাথে Sanitization Guard থাকা প্রয়োজন।
এখন প্রতিটি মেথড বা অপারেশনের ভেতর বারবার ম্যানুয়ালি এমন wrapper কল করাটাও অনেকের কাছে বেশ ক্লান্তিকর লাগতে পারে। তাছাড়া হিউম্যান এরর তো আছেই ভুল করে কোনো একটা মেথডে wrapper দিতে ভুলে গেলেই সেই step এর ট্রেসিং মিস হয়ে যাওয়ার বড় ঝুঁকি থাকে। তাহলে প্রশ্ন হলো, এর চেয়েও কি আরও স্মার্ট এবং ক্লিন কোনো অ্যাপ্রোচ আমরা ব্যবহার করতে পারি?
ES6 Proxy / Interceptor: কোড পলিউট না করে অটোমেটিক লগিং
Node.js এ আমরা Proxy ব্যবহার করে পুরো সার্ভিস instance কে একটি সিঙ্গেল লেয়ার দিয়ে wrap করে ফেলতে পারি। এতে সার্ভিসের ভেতর যতগুলো মেথডই থাকুক না কেন, মেথড কল হওয়ার সাথে সাথেই proxy ব্যাকগ্রাউন্ডে তা intercept করবে। তবে প্রোডাকশনে এটি করার সময় একটি বড় বিপদের ঝুঁকি থাকে Uncontrolled Output Logging।
কোনো একটি মেথড যদি ভুলবশত ১০ হাজার ইউজারের অবজেক্ট কিংবা বিশাল ফাইল বাফার রিটার্ন করে, আর সেটা স্যানিটাইজ না করে সরাসরি লগে পাঠাতে যায় সার্ভারের মেমোরি আউট অব মেমোরি হয়ে পুরো নোড প্রসেস নিমেষেই ক্র্যাশ করবে! তাই প্রক্সির সাথে Sanitization Guard থাকা প্রয়োজন।
const sanitizeOutput = (result) => {
   if (!result || typeof result !== 'object') return result;
   if (Buffer.isBuffer(result)) return `[Buffer: ${(result.length / 1024).toFixed(2)} KB]`;
   if (Array.isArray(result)) {
       return {
           summary: `Array with ${result.length} items`,
           data: result.map(maskSensitiveData)
       };
   }
   const masked = maskSensitiveData(result);
   const serialized = JSON.stringify(masked);
   return serialized && serialized.length > 2048
       ? { byteSize: serialized.length, preview: serialized.slice(0, 200) + '... [TRUNCATED]' }
       : masked;
};

const autoLogProxy = (instance, serviceName = instance.constructor.name) => {
   return new Proxy(instance, {
       get(target, propKey, receiver) {
           const originalMethod = Reflect.get(target, propKey, receiver);
           if (typeof originalMethod !== 'function' || propKey === 'constructor' || propKey === 'then') {
               return originalMethod;
           }

           return async function (...args) {
               const startTime = Date.now();
               const context = `${serviceName}.${String(propKey)}`;

               logger.info(`[START] ${context}`, { layer: 'Service', args: maskSensitiveData(args) });

               try {
                   const result = await originalMethod.apply(receiver, args);
                   logger.info(`[SUCCESS] ${context}`, {
                       layer: 'Service',
                       durationMs: Date.now() - startTime,
                       output: sanitizeOutput(result)
                   });

                   return result;
               } catch (error) {
                   logger.error(`[FAILED] ${context}`, {
                       layer: 'Service',
                       durationMs: Date.now() - startTime,
                       errorMessage: error.message
                   });
                   throw error;
               }
           };
       }
   });
};
এবার আমাদের সার্ভিস ক্লাসের দিকে লক্ষ্য করুন। প্রতিটি লাইনে লাইনে logger.info() লিখে কোড pollute না করে! পুরো সার্ভিস ক্লাসের ভেতরে এক লাইনও অপারেশনাল লগিং কোড নেই। শুধু বিজনেস ফ্লো এর শেষে গুরুত্বপূর্ণ Audit Ledger সংরক্ষণ করার লজিকটুকু ছাড়া, বাকি পুরো লগিং প্রসেসটাই এখন একদম অটোমেটিক
class TransferService {
   async validatePayload(payload) { ... }
   async callMisApi(accountId) { ... }
   async executeCoreTransfer(accountId, amount) { ... }
   async fundTransfer(payload) {
       const { accountId, amount, checkerId } = payload;

       try {
           await this.validatePayload(payload);

           const account = await this.callMisApi(accountId);
           if (account.availableBalance < amount) {
               throw new Error(`Insufficient funds: Available ${account.availableBalance}, Requested ${amount}`);
           }

           const transferResult = await this.executeCoreTransfer(accountId, amount);

           // Explicit Audit Ledger Save
           const ledger = await this.saveAuditLedger({
               action: 'FUNDS.TRANSFER',
               status: 'SUCCESS',
               entityId: transferResult.trxId,
               metadata: { accountId, amount, checkerId }
           });

           return { ...transferResult, auditReference: ledger.id };

       } catch (error) {
           await this.saveAuditLedger({
               action: 'FUNDS.TRANSFER',
               status: 'FAILED',
               failureReason: error.message,
               metadata: { accountId, amount, checkerId }
           }).catch(console.error);

           throw error;
       }
   }
}

export default autoLogProxy(new TransferService());
লক্ষ্য করে দেখুন আমরা যখন fundTransfer কল করব, তখন তার ভেতরের validatePayload, callMisApi এবং executeCoreTransfer প্রতিটি স্টেপ স্বয়ংক্রিয়ভাবে আলাদা সাব ট্রেস হিসেবে লগ হয়ে যাবে। কোন Step এ কত মিলিসেকেন্ড সময় লাগল, আর কোথায় গিয়ে ফেইল করল তা দেখতে সার্ভিসের ভেতরে এক লাইন কোড লিখতে হয়নি।
কন্ট্রোলারে এর ব্যবহার
class TransferController {
   handleFundTransfer = async (req, res) => {
       const result = await transferService.fundTransfer(req.body);
       res.status(200).json({ success: true, data: result });
   };
}

router.post('/transfer', transferController.handleFundTransfer);
এখন পুরো ফ্লো থেকে দুটি কাজ করা সম্ভব:
প্রথমত, বিজনেস ক্রিটিক্যাল ইভেন্টগুলোর জন্য একটি Structured Audit Ledger PostgreSQL এ রেকর্ড করা। প্রতিটি গুরুত্বপূর্ণ ইউজার অ্যাক্টিভিটি এখানে স্ট্রাকচার্ড ও ইমিউটেবল আকারে সংরক্ষিত থাকে, যা লিগ্যাল কমপ্লায়েন্স ও অডিটের জন্য ব্যবহার করা যায়:
| Action | বিবরণ |
| --- | --- |
| `AUTH.LOGIN` | ইউজার লগইন করেছে |
| `ACCOUNT.BALANCE_CHECK` | অ্যাকাউন্ট ব্যালেন্স দেখেছে |
| `TRANSACTION.HISTORY_VIEW` | ট্রানজেকশন হিস্ট্রি দেখেছে |
| `BENEFICIARY.ADD` | নতুন বেনিফিশিয়ারি যোগ করেছে |
| `FUNDS.TRANSFER` | ফান্ড ট্রান্সফার করেছে |
| `FUNDS.REFUND_REQUEST` | রিফান্ড রিকোয়েস্ট করেছে |
| `STATEMENT.EXPORT` | অ্যাকাউন্ট স্টেটমেন্ট এক্সপোর্ট করেছে |দ্বিতীয়ত, থার্ড পার্টি এপিআই কলগুলো (যেমন CBS, MIS, পেমেন্ট গেটওয়ে) autoLogProxy দিয়ে র্যাপ করা থাকলে সেগুলোর এক্সিকিউশন টাইম, ইনপুট ও আউটপুট স্বয়ংক্রিয়ভাবে লগ হয়। আর যদি কোনো থার্ড পার্টি সার্ভিস প্রক্সির বাইরে থাকে, তাহলে সেই আনস্ট্রাকচার্ড লগটি সরাসরি Loki তে পাঠানো যায়, ডাটাবেসে বিশাল আকারের আনস্ট্রাকচার্ড ডেটা store ছাড়াই।
Generic অডিট লেজার স্কিমা (PostgreSQL)
ডাটাবেসে সব গুরুত্বপূর্ণ বিজনেস অ্যাক্টিভিটি লিগ্যাল ও কমপ্লায়েন্স অডিটের জন্য আমরা Actor-Action-Entity প্যাটার্নে একটি জেনেরিক Immutable টেবিল ব্যবহার করতে পারি। তবে এটি কোনো চূড়ান্ত স্কিমা নয় আপনার প্রোডাক্ট ও ডোমেইনের প্রয়োজন অনুযায়ী কলাম যোগ বা বাদ দেওয়া যেতে পারে।
CREATE TABLE IF NOT EXISTS audit_logs (
   id          BIGSERIAL    PRIMARY KEY,
   trace_id    UUID,
   user_id     <VARCHAR(64) OR  UUID Ref>,
   ip          INET,
   user_agent  VARCHAR(255),
   action      VARCHAR(64)  NOT NULL, -- 'AUTH.LOGIN', 'FUNDS.TRANSFER'...
   method VARCHAR(8)
   entity_type VARCHAR(50), -- 'TRANSACTION', 'ACCOUNT', 'USER'
   entity_id   VARCHAR(64),
   failure_reason TEXT,
   metadata    JSONB        DEFAULT '{}'::jsonb,
   created_at  TIMESTAMPTZ  DEFAULT CURRENT_TIMESTAMP NOT NULL
);

CREATE OR REPLACE RULE no_update_audit AS ON UPDATE TO audit_logs DO INSTEAD NOTHING;
CREATE OR REPLACE RULE no_delete_audit AS ON DELETE TO audit_logs DO INSTEAD NOTHING;
দুই স্তরে অডিট ট্রেইল অনুসন্ধান এই আর্কিটেকচারের সবচেয়ে বড় সুবিধা হলো একটিমাত্র Trace ID দিয়ে দুই জায়গা থেকেই পূর্ণাঙ্গ ছবি পাওয়া সম্ভব।
PostgreSQL Audit Ledger থেকে কোন ইউজার সিস্টেমে কী কী গুরুত্বপূর্ণ কাজ করেছে, তার পুরো হিস্ট্রি (অর্থাৎ কে, কখন, কী করেছে এবং সেটি success হয়েছে কি না) মাত্র একটি SQL কুয়েরিতেই বের করে ফেলা যায়। আর সেই রেকর্ডে থাকা trace_id ব্যবহার করে Grafana Loki তে সার্চ করলে, ওই নির্দিষ্ট রিকোয়েস্টের সার্ভিস লেভেল এক্সিকিউশন ফ্লো, ইনপুট/আউটপুট ডেটা এবং স্ট্যাক ট্রেস একসাথে দেখা যায়।
Grafana Loki কুয়েরি:
{app="banking-backend"} | json | traceId="9710e62e-65b4-49d8-966c-ef7c84b64377"সম্পূর্ণ আউটপুটটি সুস্পষ্ট:
[Trace: 9710e62e...] [User: USR-HASAN-77] [START]   TestService.fundTransfer
[Trace: 9710e62e...] [User: USR-HASAN-77] [START]   TestService.validatePayload
[Trace: 9710e62e...] [User: USR-HASAN-77] [SUCCESS] TestService.validatePayload   (0ms)
[Trace: 9710e62e...] [User: USR-HASAN-77] [START]   TestService.callMisApi
[Trace: 9710e62e...] [User: USR-HASAN-77] [SUCCESS] TestService.callMisApi        (31ms)
[Trace: 9710e62e...] [User: USR-HASAN-77] [START]   TestService.executeCoreTransfer
[Trace: 9710e62e...] [User: USR-HASAN-77] [SUCCESS] TestService.executeCoreTransfer (42ms)
[Trace: 9710e62e...] [User: USR-HASAN-77] [START]   TestService.saveAuditLedger
[Trace: 9710e62e...] [User: USR-HASAN-77] [SUCCESS] TestService.saveAuditLedger   (0ms)
[Trace: 9710e62e...] [User: USR-HASAN-77] [SUCCESS] TestService.fundTransfer      (74ms)
[Trace: 9710e62e...] [User: USR-HASAN-77] [HTTP_RESPONSE] POST /api/transfer - 200 (75ms)
এতে ইঞ্জিনিয়ারকে আর সার্ভারে ঢুকে হাজার হাজার লাইনের লগ খুঁজতে হয় না এবং মূল ডাটাবেসও অপ্রয়োজনীয় ডেটায় ভারী হয় না। মাত্র একটি Trace ID ব্যবহার করেই পুরো ট্রানজেকশন ফ্লো খুব সহজেই ট্র্যাক করা যায়।
Main things:
- সাধারণ নয়েজি লগ যাবে Loki তে, কমপ্লায়েন্স অডিট থাকবে PostgreSQL এ।
- ক্লায়েন্টের Trace ID কখনো বিশ্বাস করবেন না — সার্ভার নিজেই তা তৈরি করবে।
- সার্ভিসে ম্যানুয়াল লগিং কোড না লিখে Proxy Pattern / Interceptor ব্যবহার করুন
- বারবার catchAsync না লিখে সেন্ট্রালাইজড এরর হ্যান্ডলিং ব্যবহার করুন।
- সফল ট্রানজেকশনের পাশাপাশি ফেইলিউর ও এররগুলোও Audit Ledger এ সেভ রাখুন।
Distributed Tracing: বড় স্কেলের মাইক্রোসার্ভিস বা Distributed System-এর ক্ষেত্রে Grafana Tempo, Datadog বা AWS X-Ray-এর মতো ডেডিকেটেড টুল ব্যবহার করতে পারেন। ইনস্ট্রুমেন্টেশনের জন্য গ্লোবাল স্ট্যান্ডার্ড হিসেবে OpenTelemetry (OTel) বিবেচনা করতে পারেন.
NodeJS #Express5 #BackendEngineering #SoftwareArchitecture #DevOps #Microservices #Grafana #Fintech #SystemDesign #CleanCode #BanglaTech